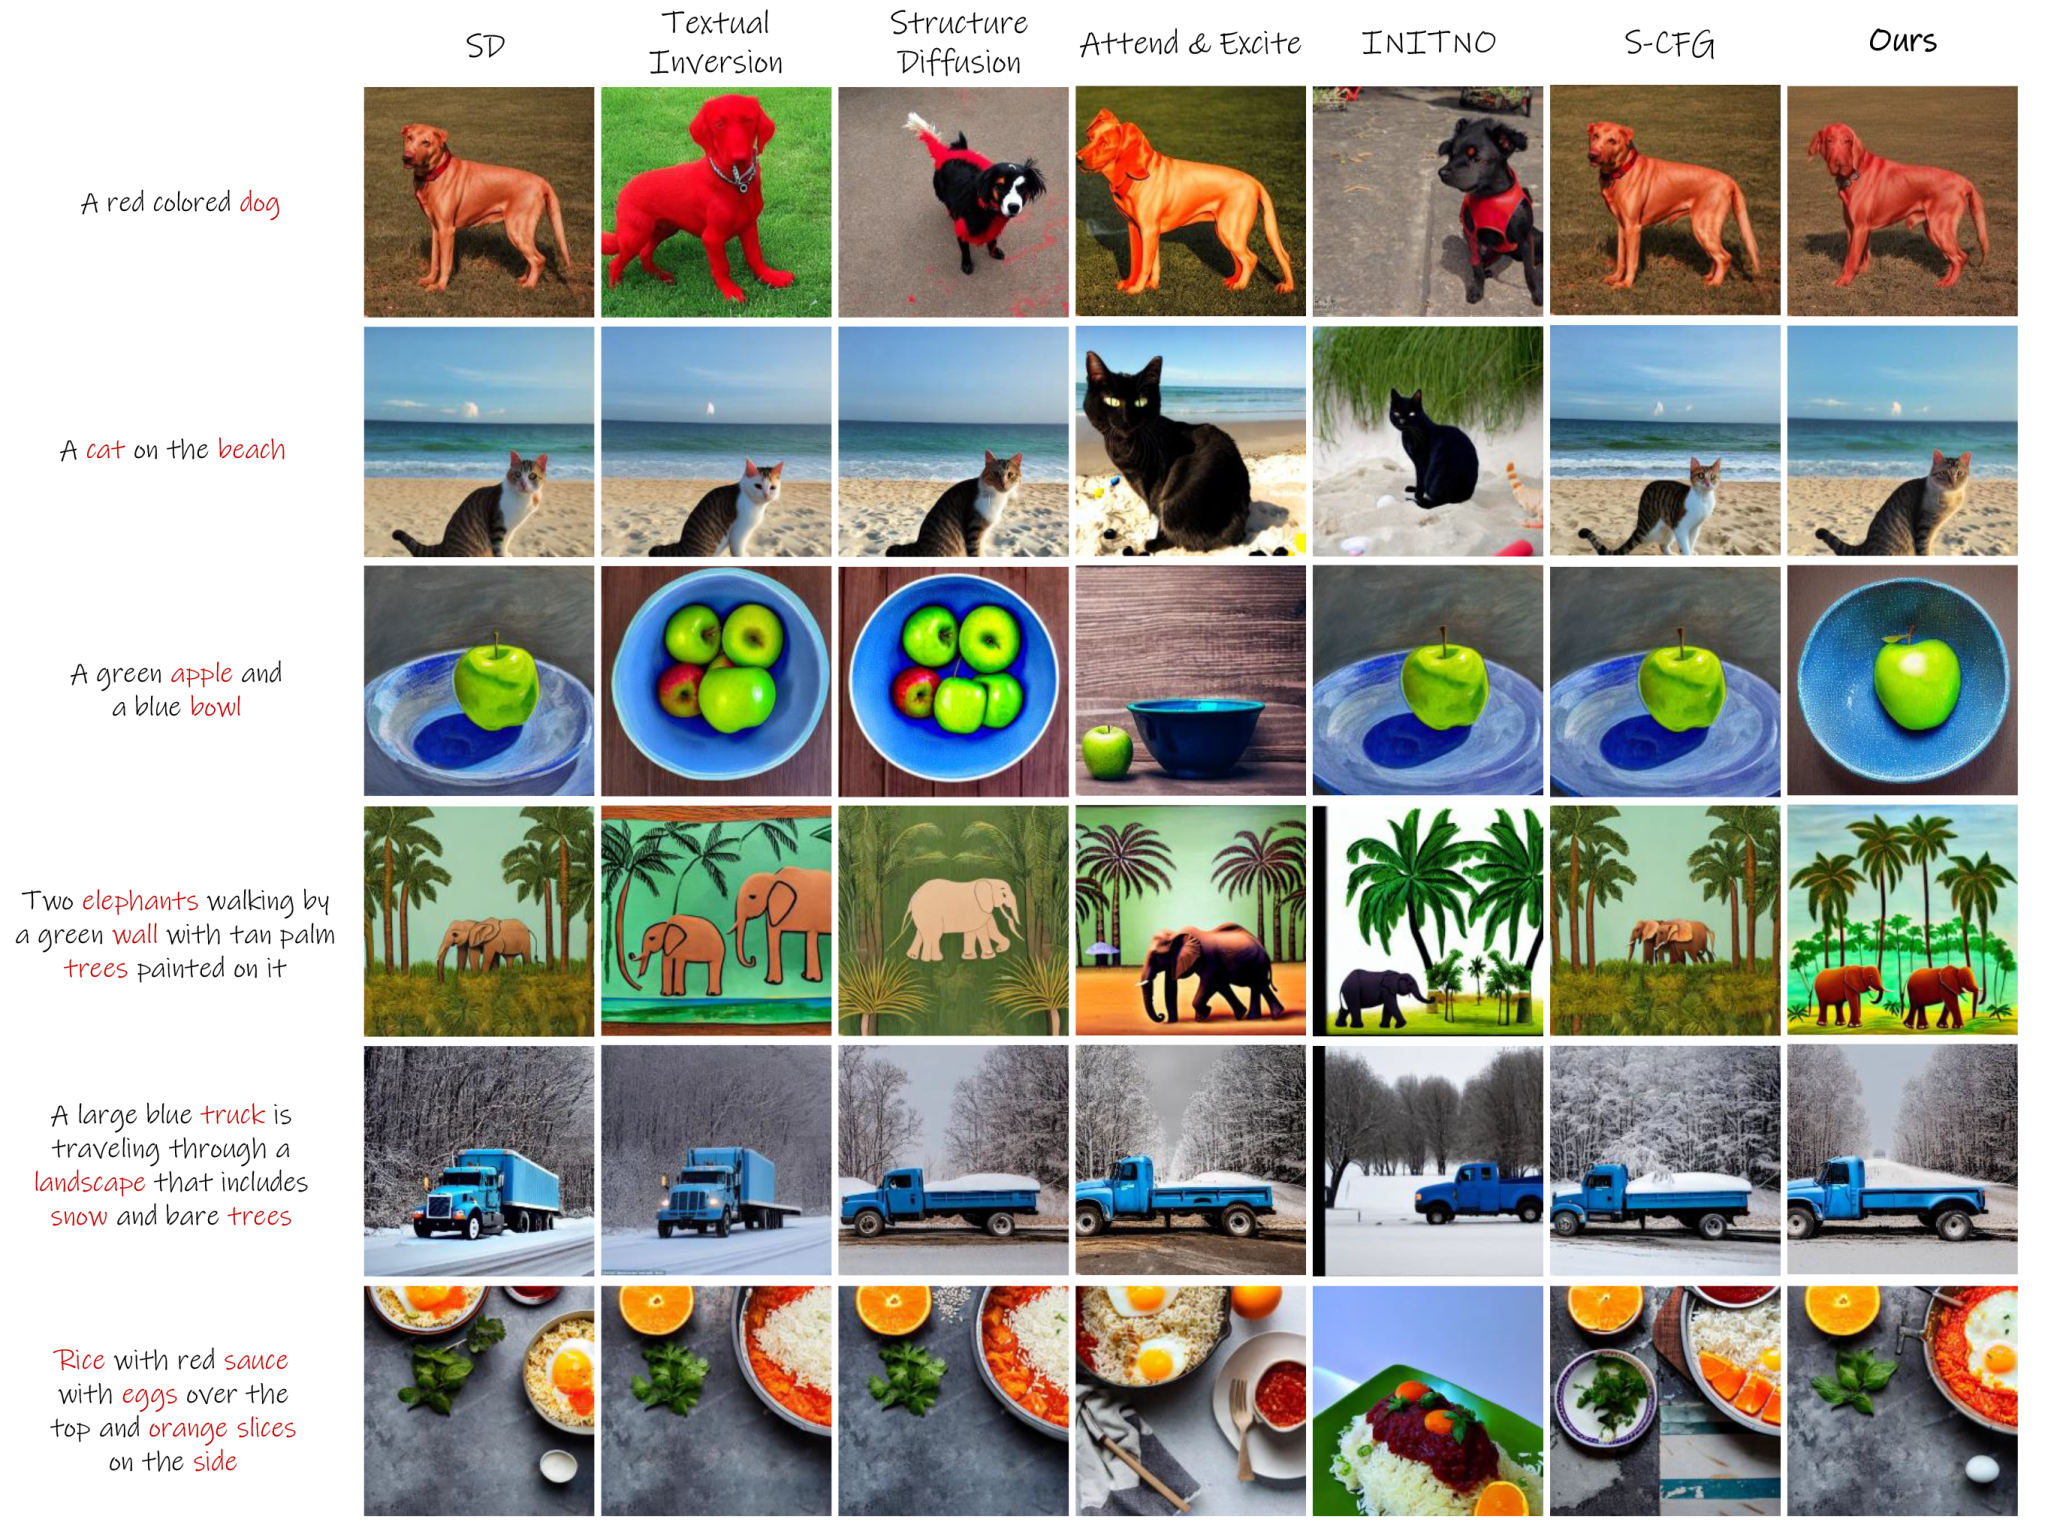
近日,beat365在线唯一官网陕西省服装设计智能化重点实验室鲁棒视觉智能感知技术团队在多模态通用图像可控生成研究方向取得重要研究进展。由张凯兵教授指导、2024级硕士研究生王骏巍同学完成的学术论文《ConsistDiff: Training-Free Reinforcement Learning for Semantically Consistent Text-to-Image Generation》成功被国际人工智能与计算机神经科学领域顶级期刊Neural Networks录用。Neural Networks是国际神经网络学会(INNS)等三大神经建模协会的官方期刊,聚焦神经网络与计算智能领域,为中科院SCI期刊分区计算机科学大类二区TOP期刊、中国计算机学会CCF推荐人工智能领域B类期刊,2025-2026年最新影响因子为7.2。文本到图像生成(Text-to-Image Generation, T2I)是计算机视觉与多模态人工智能领域的重要研究方向,旨在根据自然语言描述生成高质量、语义一致的图像,为数字内容创作与智能设计等应用提供技术支撑。近年来,基于扩散模型的图像生成方法取得显著进展,但在处理包含多个对象、属性及关系的复杂描述时,仍容易出现对象遗漏、属性混淆及属性与对象对应错误等问题,且部分现有方法依赖额外训练、模型微调或复杂的迭代优化,难以兼顾语义一致性与生成效率。针对上述问题,提出一种无需微调扩散骨干的语义一致性文本到图像生成框架ConsistDiff。该方法通过设计上下文感知注意力机制,结合名词短语解析与字符级位置距离,优化对象及其修饰词的权重分配,增强属性与对象之间的语义关联。同时,将去噪过程中的词元权重调整建模为在线强化学习任务,采用轻量级Q-learning策略,根据生成过程中的注意力反馈动态调整文本引导。此外,引入注意力分离奖励,鼓励不同对象的注意力分布保持可区分性,减少跨对象语义干扰与属性混淆。实验结果表明,ConsistDiff在多个数据集上提升了生成图像与文本描述的语义一致性,并在组合语义生成以及颜色、形状属性绑定等多项评测实验中均取得了很好的性能,为可控文本到图像生成提供了新的创新思路。
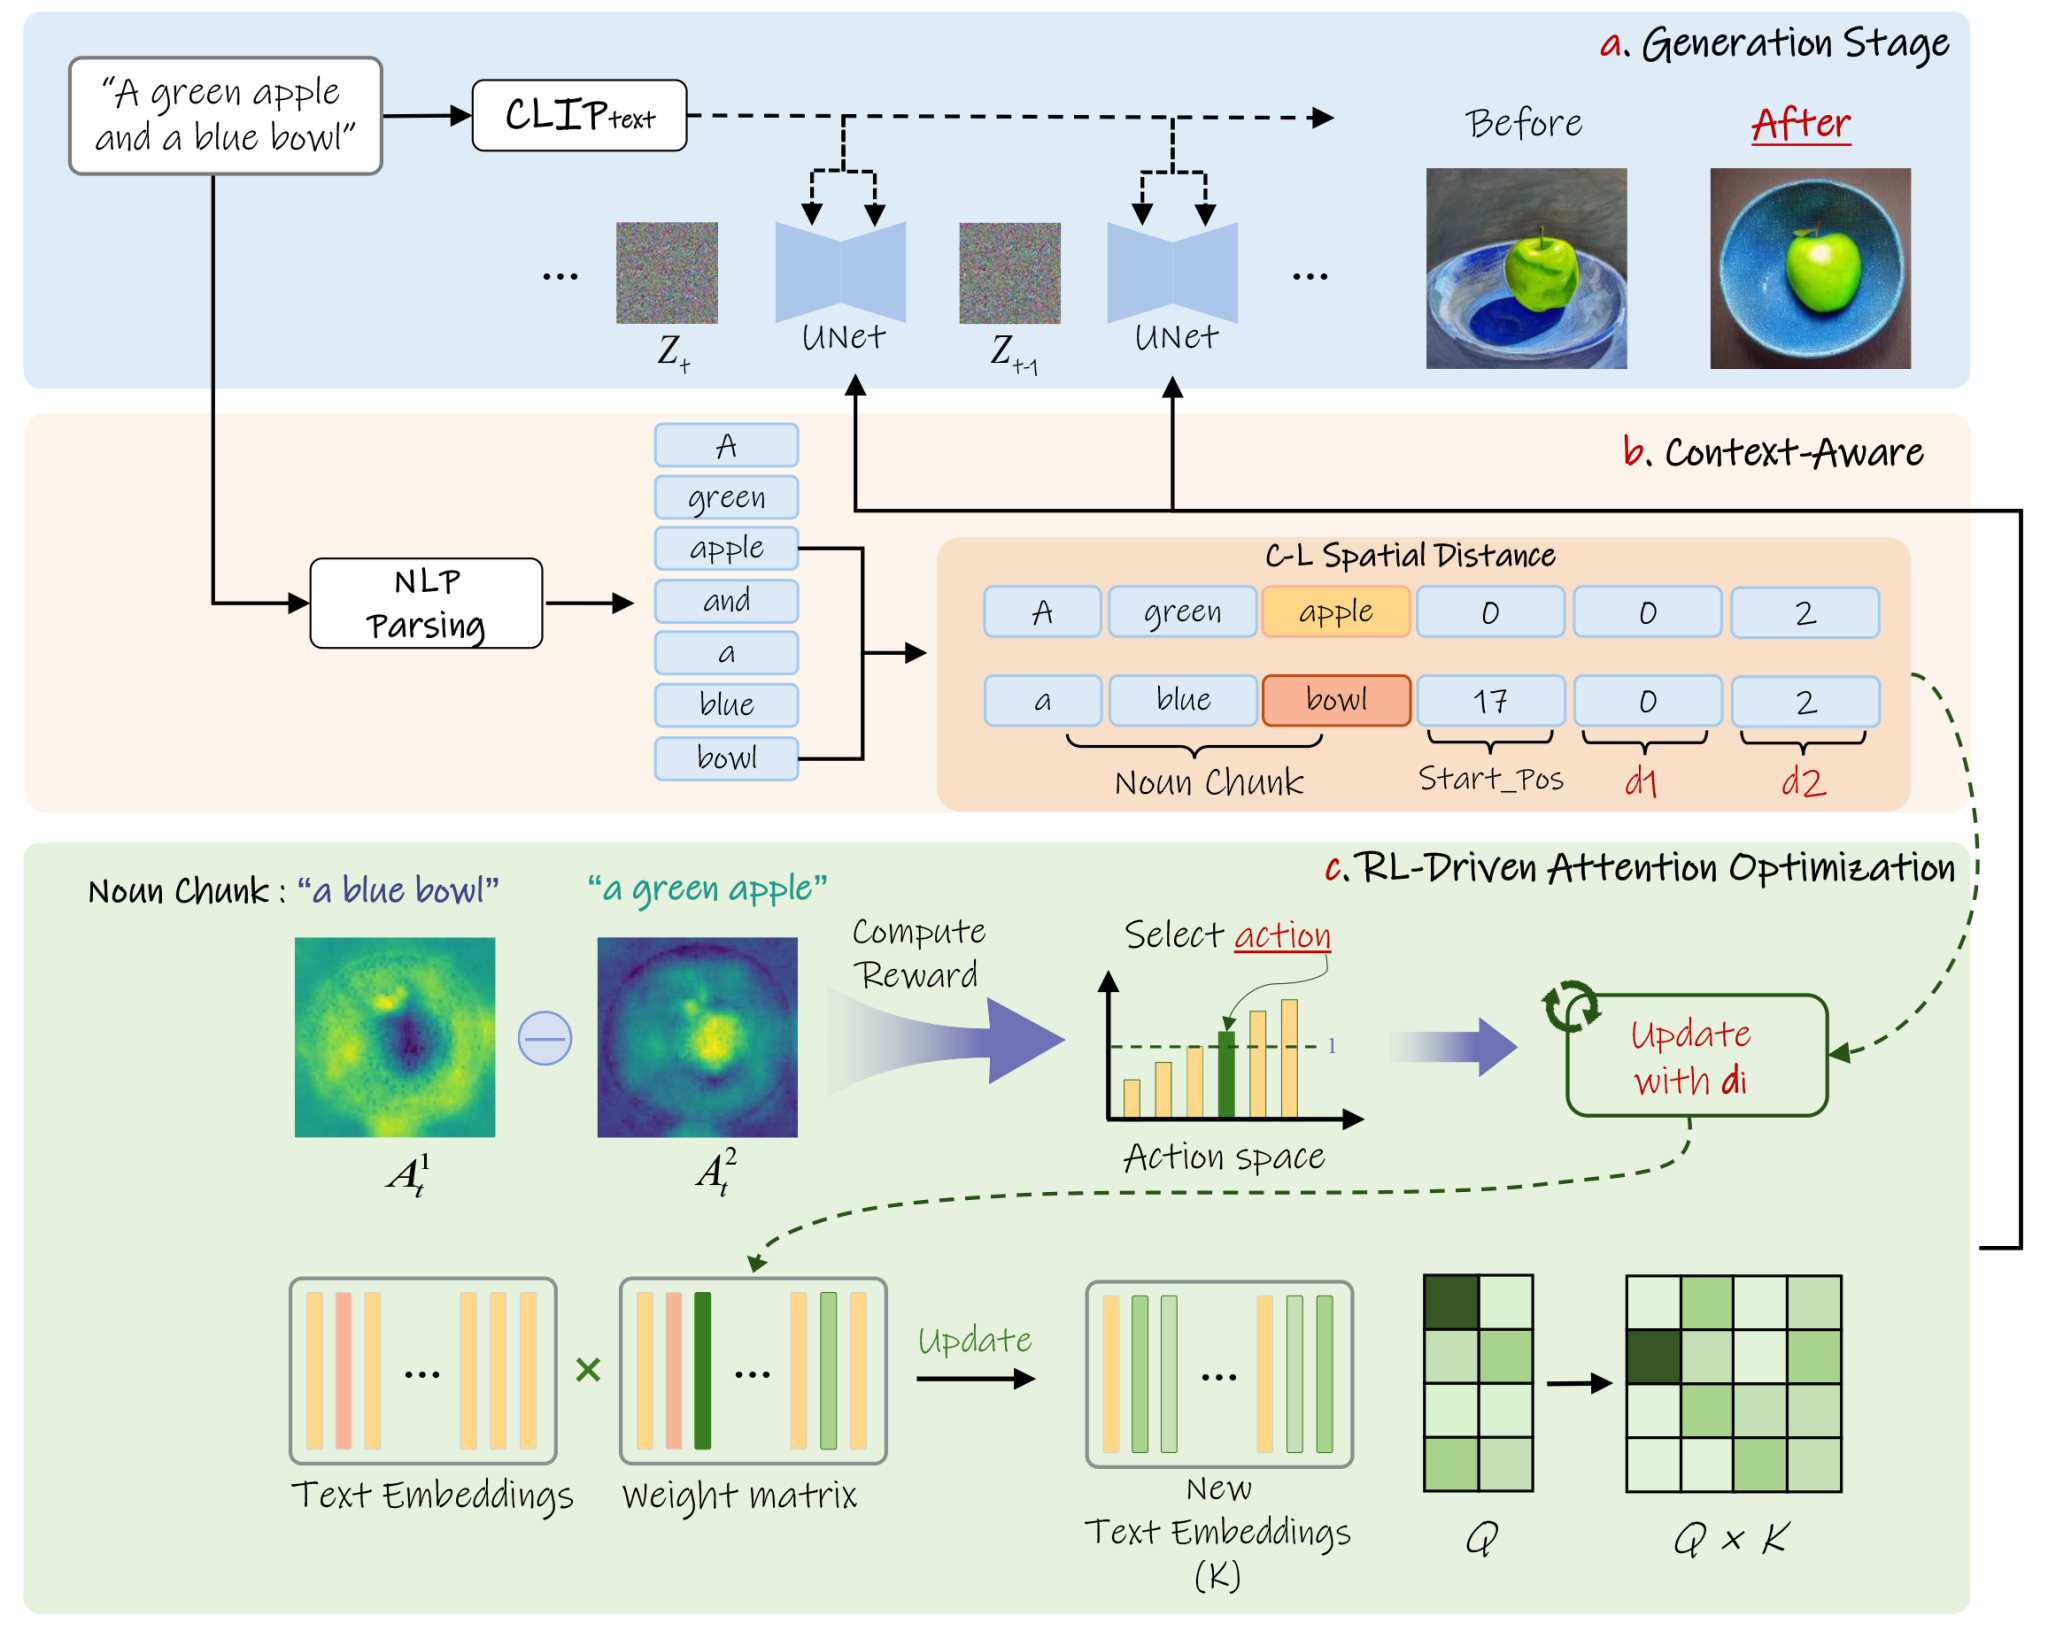
图1 ConsistDiff总体框架